Apa Itu OCR? Cara Mengubah Hasil Scan Jadi Teks
Penjelasan OCR dan cara mengubah PDF hasil scan atau foto dari HP menjadi tulisan yang bisa disalin dan dicari, langsung di browser tanpa mengunggah file.
Oleh Alfiki DiastamaTerbit 3 menit baca
Daftar isi
OCR membuat komputer bisa membaca tulisan di gambar. Jadi, tulisan itu bisa kamu blok, salin, dan cari lewat tombol Ctrl+F. Di Dely PDF, alat OCR PDF bisa mengubah PDF hasil scan atau foto dari HP jadi PDF yang tulisannya bisa disalin, langsung di browser.
Kenapa tulisan di PDF hasil scan tidak bisa disalin
PDF hasil scan atau foto sebenarnya hanyalah gambar. Komputer melihatnya sebagai kumpulan titik warna (piksel), bukan sebagai huruf. Karena itu tidak ada teks yang bisa diblok atau disalin, dan kamu tidak bisa mencari isi teksnya dengan Ctrl+F.
Cara cepat untuk mengeceknya adalah dengan mencoba memblok tulisan di PDF-mu. Kalau yang terpilih satu halaman utuh sekaligus, atau tidak ada yang terpilih sama sekali, berarti halaman itu masih berupa gambar.
Apa yang dilakukan OCR
OCR (Optical Character Recognition) membaca bentuk tulisan di gambar, lalu menebak huruf dan kata yang ada di sana. Hasil tebakannya dipasang sebagai lapisan teks yang tidak terlihat, tepat di atas gambar aslinya.
Karena lapisan itu tidak terlihat, tampilan halaman tidak berubah sama sekali. Bedanya, sekarang kamu bisa menyeleksi kalimat, menyalinnya, dan mencari kata di seluruh halaman.
Cara memakai OCR di Dely PDF
Buka alat OCR PDF
Alatnya ada di halaman OCR PDF milik Dely PDF.
Tambahkan PDF atau foto
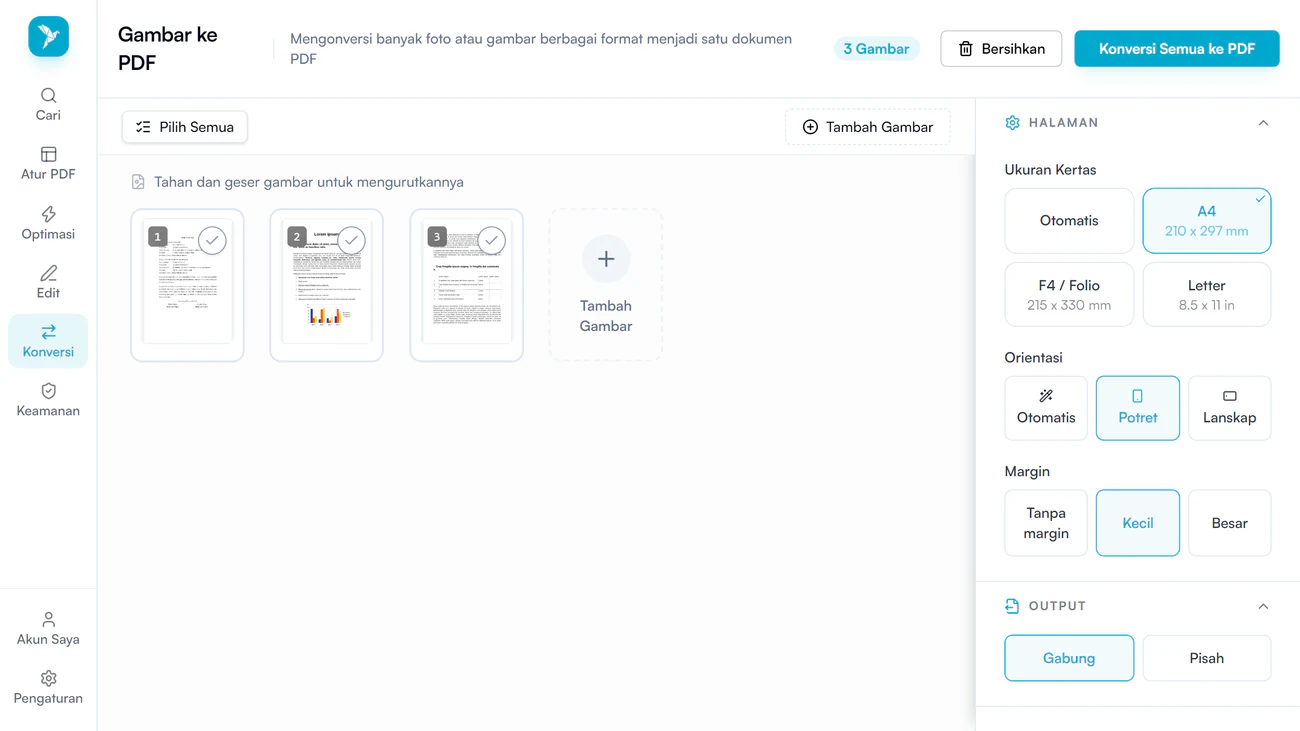
Pilih PDF hasil scan, atau foto JPG dan PNG langsung dari HP. Foto akan diproses menjadi satu PDF.
Pilih bahasa
Pilih Indonesia atau Inggris sesuai isi dokumen, supaya tulisannya lebih akurat dikenali.
Jalankan lalu unduh
Setelah selesai, unduh PDF hasilnya, lalu coba blok satu kalimat atau cari satu kata untuk memastikan tulisannya sudah terbaca.
OCR PDF
Membantu membuat PDF dengan teks yang dapat dicari dan disalin dari hasil scan.
Halaman yang sudah memiliki teks asli akan dikenali otomatis dan dibiarkan apa adanya. Hanya halaman yang berupa gambar yang diproses, jadi PDF campuran antara teks biasa dan hasil scan aman dipakai.
Apa yang memengaruhi akurasi
OCR pada dasarnya menebak, jadi hasilnya tidak selalu sempurna. Hal yang paling berpengaruh adalah kejernihan scan atau foto, kemiringan halaman, pencahayaan yang merata, dan bahasa yang kamu pilih. OCR kadang masih salah mendeteksi teks pada foto yang buram atau terkena bayangan.
Tulisan tangan dan font dengan bentuk yang unik biasanya jauh lebih sulit dikenali daripada teks cetak. Prosesnya juga membutuhkan beberapa detik per halaman, jadi dokumen yang panjang bisa memakan waktu beberapa menit.
OCR tidak mengubah PDF jadi Word
Banyak orang mencari OCR karena ingin hasil scan menjadi dokumen Word yang bisa diedit bebas. Alat OCR di Dely PDF tidak melakukan itu. Hasilnya tetap berupa PDF, hanya saja tulisannya sekarang bisa dicari dan disalin.
Kalau kamu perlu mengedit tulisannya, gunakan alat konversi PDF ke Word. Namun, layout hasil konversinya kadang berubah, jadi kamu mungkin perlu merapikannya lagi.
Apakah file ikut diunggah?
Tidak. Proses OCR dijalankan di browser, jadi isi file tidak dikirim ke server. Browser mengunduh programnya lebih dulu, termasuk data bahasa untuk mengenali tulisan, lalu pekerjaannya dilakukan di perangkatmu. Penjelasan lengkapnya ada di artikel apa itu WebAssembly.
Ringkasan
OCR mengubah PDF hasil scan atau foto jadi PDF yang tulisannya bisa diblok, disalin, dan dicari, tanpa mengubah tampilan halamannya. Pakai alat OCR PDF di Dely PDF, pilih bahasa yang sesuai, lalu jalankan. Hasilnya tetap PDF, bukan Word, dan akurasinya paling baik kalau scan-nya jelas.